
Qué es llms.txt
llms.txt es un archivo de texto en formato Markdown que se coloca en la raíz de un dominio (/llms.txt) y actúa como mapa de contenido para los modelos de lenguaje, la idea del llm.txt es señalar qué páginas del sitio merecen la atención de un agente de IA y ofrecer versiones limpias de ese contenido en Markdown, sin el ruido del HTML, es importante entender que no es un estándar oficial, no lo exige ningún buscador ni ninguna plataforma de IA, y no controla el rastreo.
Una analogía que funciona sería el robots.txt, el robots.txt le dice a los rastreadores por dónde no pasar, y sitemap.xml le dice a Google qué páginas existen, con los llms.txt le decimos a un agente de IA qué merece la pena leer y dónde encontrarlo en un formato que no le cueste caro procesar.
¿Por qué existe? El problema de los tokens desperdiciados
Las páginas web modernas están llenas de cosas que no son contenido que aportan información, es decir, menús de navegación, banners, scripts de analítica, cookies, widgets del chat de soporte, pie de página con cuarenta enlaces… Todo eso ocupa espacio en la ventana de contexto de un LLM, que tiene un límite de tokens, por tanto , cuando un agente de IA lee una página web para responder una pregunta o ejecutar una tarea, una parte significativa de esos tokens se va en un “contenido” que no aporta información útil para el sistema.
El problema no es menor en sitios con mucho contenido,ya que un ecommerce con fichas de producto largas, un SaaS con documentación técnica extensa o un medio con miles de artículos tienen que confiar en que el agente sepa qué ignorar y el llms.txt intenta resolver esto de forma proactiva, ya que el sitio declara, en un formato limpio y legible para el sistema, cuál es su contenido principal y cómo acceder a versiones en Markdown de cada página.
Quién lo propuso y cómo ha evolucionado
Jeremy Howard, cofundador de Answer.AI, lo propuso en septiembre de 2024, y la idea era simple, estandarizar una forma de que los agentes de IA entendieran el contenido de un sitio de manera más eficiente, del mismo modo que robots.txt estandarizó las instrucciones para los rastreadores en los noventa.
En agosto de 2026 llegó la versión 2, con cinco cambios concretos que vale la pena entender.
Descubrimiento explícito mediante etiquetas rel. La v1 no tenía un mecanismo para que la IA supiera que existía una versión Markdown de una página concreta, con la v2 el standard permite incluir etiquetas rel="alternate" y rel="describedby" en el HTML o en la cabecera HTTP para señalar directamente, «aquí está mi versión en Markdown», con lo que se gana en facilidad de localización y más información estructurada.
Nombres de archivo más flexibles. La v1 exigía la extensión .html.md para las versiones Markdown de cada página, con la v2 permite también la extensión .md directamente (por ejemplo, pagina.md), que es el formato que generan por defecto la mayoría de herramientas, un cambio pequeño pero con impacto práctico real para quien genera estos archivos de forma automática.
Soporte para subcarpetas. Ahora también puedes colocar un llms.txt dentro de un directorio, por ejemplo en /documentacion/llms.txt, y ese archivo afectará solo al contenido de esa carpeta, si hay varios archivos en el sitio, el agente de IA usa el más específico respecto a la ruta en la que está navegando y esto tiene mucho sentido especialmente en sitios grandes con secciones muy diferenciadas.
Eliminación de la herramienta llms_txt2ctx. En la v1 se proponía esta herramienta para empaquetar todo el contenido del archivo y volcarlo de golpe en la memoria del modelo, pero la v2 del standard la elimina, ahora la IA usa llms.txt como un mapa para consultar y abrir solo el enlace .md que necesita en cada momento, en lugar de cargar todo el contexto de una vez.
La sección “Optional” pierde sus reglas técnicas. Al desaparecer llms_txt2ctx, la sección Optional del archivo pierde la función técnica que tenía (indicar qué omitir al empaquetar el contexto) y pasa a ser una convención visual para agrupar enlaces secundarios sin ninguna mecánica especial detrás.
Diferencias con robots.txt y sitemap.xml
Los tres archivos conviven sin pisarse porque hacen cosas realmente distintas.
robots.txt controla el acceso de rastreadores: les dice qué URLs pueden o no pueden visitar, en el fondo, es una instrucción de permiso, no de contenido.
sitemap.xml enumera URLs para que los buscadores las descubran e indexen, su foco son los motores de búsqueda, no los agentes de IA, y no se enfoca nada en la calidad ni la relevancia del contenido.
llms.txt no controla el rastreo ni enumera páginas para buscadores. Su función es meramente editorial, seleccionar el contenido más relevante del sitio y ofrecerlo en un formato que los LLMs puedan consumir sin desperdiciar tokens. Puedes tener los tres a la vez sin ningún conflicto.
Estructura del archivo: qué lleva y qué no
El formato es Markdown, lo que significa que cualquier editor de texto simple sirve para crearlo y editarlo y la estructura básica tiene tres partes:
- El nombre del sitio o proyecto.
- Un bloque de descripción breve (opcional pero recomendado) que explica de qué va el sitio.
- Grupos de enlaces a las páginas más relevantes, con una descripción corta para cada uno.
Un ejemplo mínimo podría verse así:
# Nombre del sitio

Breve descripción de qué ofrece este sitio y a quién va dirigido.

## Sección principal

- [Título de la página](https://dominio.com/pagina.md): descripción breve de qué contiene.
- [Otra página](https://dominio.com/otra-pagina.md): descripción breve.

## Optional

- [Página secundaria](https://dominio.com/secundaria.md): contenido complementario.
Los enlaces apuntan a las versiones Markdown de cada página, no al HTML, eso es lo que permite al agente de IA acceder directamente al contenido limpio.
Qué es llms-full.txt y cuándo tiene sentido
llms-full.txt es una variante que reúne todo el contenido relevante del sitio en un único archivo, sin que el agente tenga que seguir enlaces individuales, tiene utilidad en sitios de documentación técnica donde el consumo automatizado es habitual, es decir, una librería de software, una API pública, un SDK con muchos métodos.
Para la mayoría de webs corporativas, blogs o ecommerce, llms-full.txt es excesivo, ya que un archivo que acumula miles de palabras de contenido de golpe puede ser contraproducente si los agentes no están diseñados para procesarlo de esa forma, y el mantenimiento se complica más que el del archivo estándar.
Cómo crear e implementar llms.txt paso a paso
La implementación técnica es sencilla, lo que realmente es complicado es la parte editorial, es decir, decidir qué incluir.
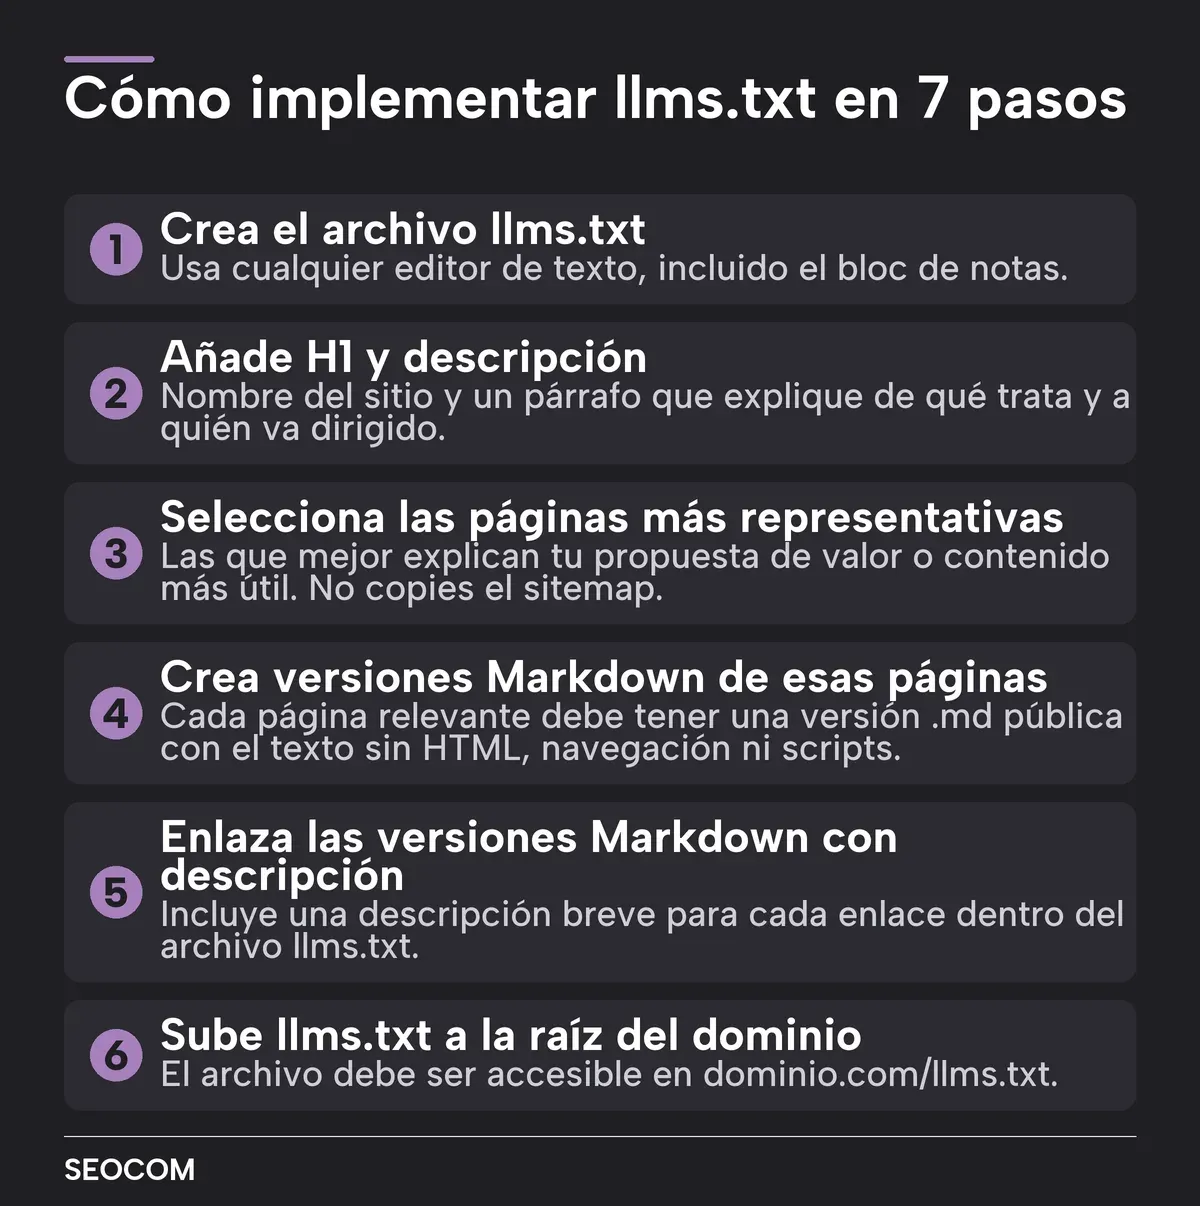
Paso 1. Crea un archivo de texto llamado llms.txt. Puedes hacerlo con cualquier editor, incluido el bloc de notas.
Paso 2. Añade el H1 con el nombre del sitio y un párrafo de descripción que explique de qué trata y a quién va dirigido.
Paso 3. Selecciona las páginas más representativas del sitio: las que mejor explican tu propuesta de valor, tus productos o servicios principales, o tu contenido más útil, no hagas una copia del sitemap, elige lo que realmente aporta valor.
Paso 4. Crea versiones Markdown de esas páginas. Aquí está el trabajo real, ya que cada página relevante debe tener una versión .md accesible públicamente (por ejemplo, dominio.com/pagina.md) que contenga el texto sin la capa de HTML, navegación ni scripts.
Paso 5. Enlaza esas versiones Markdown desde el llms.txt con una descripción breve para cada una.
Paso 6. Sube el archivo llms.txt a la raíz del dominio para que sea accesible en dominio.com/llms.txt.
Paso 7. Si usas la v2, añade las etiquetas rel="alternate" en el HTML de cada página para que los agentes puedan descubrir su versión Markdown sin necesitar el llms.txt como punto de partida.
En sitios pequeños esto puede hacerse a mano y actualizarse cuando cambie la arquitectura del sitio y en sitios grandes, lo razonable es generarlo automáticamente desde el CMS o integrarlo en el proceso de despliegue, igual que se hace con el sitemap.
¿Quién mantiene el archivo y con qué frecuencia hay que actualizarlo?
Esta es la pregunta que casi nadie responde cuando habla de llms.txt, y es la que más importa en el día a día.
Si el archivo refleja páginas que ya no existen o secciones que han cambiado de URL, un agente de IA que lo siga encontrará errores o contenido obsoleto, el efecto no es catastrófico porque, como se explica más abajo, ningún sistema de IA de los que importan lo usa de forma activa hoy, pero si llegase al punto en que sí lo usan, tener el archivo desactualizado es peor que no tenerlo.
La regla práctica es sencilla, actualiza el llms.txt cada vez que cambies la arquitectura del sitio, elimines secciones importantes o añadas contenido nuevo que merezca estar en el mapa, en sitios con pocas páginas clave, una revisión trimestral suele bastar, en sitios que publican contenido nuevo de forma continua, la solución es la generación automática desde el CMS, igual que con el sitemap.
El responsable natural de ese mantenimiento depende del equipo, en proyectos con SEO técnico dedicado, cae en ese rol, y en equipos pequeños, lo asume quien gestiona la arquitectura del sitio.
Lo que llms.txt no hace: límites reales
Aquí es donde conviene ser realmente claros, porque hay bastante ruido alrededor de este archivo.
Ninguno de los grandes proveedores lo exige ni lo reconoce como estándar oficial, Google ha dicho en varias ocasiones que no lo usa, OpenAI y Perplexity documentan sus controles de rastreo mediante robots.txt, no mediante llms.txt, simplemente el hecho de que Anthropic, OpenAI o Google publiquen sus propios archivos llms.txt para la documentación de sus desarrolladores no significa que sus sistemas los lean para rastrear otras webs, lo hacen porque son sitios de documentación técnica con un caso de uso claro para agentes de codificación.
El llms.txt no garantiza que tu sitio aparezca en las respuestas de ChatGPT, Perplexity o los AI Overviews de Google, ya que no es un mecanismo de indexación ni de ranking, portando no controla qué dice ningún modelo sobre tu marca, su función es de facilidad de acceso, no de visibilidad.
¿Cuándo merece la pena implementarlo?
La decisión depende más del tipo de sitio que del tamaño de la empresa.
Tiene sentido si tu sitio es documentación técnica de software, una librería, una API o un producto orientado a desarrolladores, en ese contexto los agentes de codificación sí siguen el llms.txt para encontrar referencias y tutoriales, el caso de uso es claro, lo llms lo esperan y el esfuerzo de mantenimiento se justifica.
Vale la pena considerarlo si tu sitio tiene contenido muy especializado y quieres facilitar que los agentes de IA lo encuentren y lo consuman de forma eficiente. Un sitio de investigación, un think tank, una publicación técnica, aquí el beneficio es más indirecto y no garantizado, pero el coste de implementación es bajo si ya tienes el contenido bien organizado.
No lo priorices si tienes un ecommerce, un site corporativo genérico o un blog sin foco técnico, el esfuerzo de crear y mantener versiones Markdown de las páginas relevantes probablemente no justifica el retorno en el corto y medio plazo, dado que ningún sistema de IA de los que importan lo usa de forma activa hoy.
Para un CEO o CMO que no trabaja en el sector tecnológico, implementar llms.txt ahora mismo es como preparar una habitación de hotel para un huésped que quizás llegue el año que viene o quizás nunca venga, puedes hacerlo, no cuesta mucho si tienes el equipo técnico, pero no va a cambiar los resultados de mañana.
llms.txt y GEO: dónde encaja en la estrategia
Si has llegado hasta aquí porque te preocupa la visibilidad en motores de IA, conviene separar dos conversaciones que a menudo se mezclan.
llms.txt es una propuesta técnica de facilitación de acceso. GEO (Generative Engine Optimization) es la estrategia para que tu marca, tus productos o tu contenido aparezcan citados en las respuestas que generan ChatGPT, Perplexity, Gemini o los AI Overviews de Google, por tanto son capas distintas.
Lo que sí mejora tu visibilidad en IA es tener contenido de autoridad bien estructurado, con hechos verificables, con citas y datos que los modelos puedan usar como fuente fiable, también cuenta la presencia en sitios de terceros que los modelos rastrean con frecuencia, y la coherencia de lo que se dice sobre tu marca en distintos canales.El llms.txt puede ser un detalle de cortesía técnica en esa estrategia, pero nada más.
Si quieres entender cómo conseguir que ChatGPT recomiende tu marca, el punto de partida es el contenido y la autoridad, no el archivo en la raíz del dominio.
Preguntas frecuentes
¿Es obligatorio tener un llms.txt? No, ningún motor de búsqueda ni plataforma de IA lo exige, tu pagina web funciona igual sin él sin problema.
¿Puedo tener llms.txt y robots.txt a la vez? Sí, sin ningún conflicto, es más como hemos explicado hacen cosas distintas y conviven sin problema.
¿Qué pasa si no lo tengo? Nada que puedas medir hoy, los agentes de IA que rastrean la web lo hacen mediante robots.txt y sus propios sistemas de indexación, no mediante llms.txt.
¿Google, OpenAI o Perplexity exigen llms.txt? No, Google ha confirmado explícitamente que no lo usa y el mecanismo de control de rastreo para todos ellos sigue siendo robots.txt.
¿Cómo afecta al SEO? Directamente, no afecta, no es una señal de ranking para Google ni cambia la forma en que los buscadores indexan tu sitio, tener versiones Markdown bien escritas de tus páginas puede ser útil para otras cosas, pero el llms.txt en sí no mueve posiciones.
¿Lo están usando las marcas? Las que lo tienen son sobre todo empresas del sector tecnológico con documentación de desarrolladores, el caso de uso para el que fue diseñado, la adopción en webs corporativas generales o ecommerce es marginal.
¿Tiene futuro el estándar? Lleva dos años sin convertirse en estándar oficial y sin respaldo de los grandes proveedores, podría evolucionar, quizás pueda que algún sistema empiece a usarlo activamente, o puede que quede como una propuesta técnica interesante que nunca despegó del nicho de la documentación, pero por ahora no tiene una gran aceptación.
La versión 2 que llegó en agosto de 2026 mejora aspectos prácticos reales, el descubrimiento mediante etiquetas rel, la flexibilidad de nombres de archivo y el soporte para subcarpetas son cambios que facilitan la adopción, pero la pregunta de si algún sistema importante va a empezar a usarlo de forma activa sigue sin respuesta.


